AI黎明期におけるコミュニケーション
猫も杓子もAI、AIと話す時代。朝から晩まで、どのモデルが良いだの悪いだのという益体もない話が全世界を席巻している。
通勤電車に乗ると、リーマンから学生まで、誰も彼もがAI(厳密にはLLM)について話しているのを耳にする。本当に、聞かない日がないくらいである1。
かくいう私も、仕事・プライベートの両方でLLMを利用している。特に情報検索と翻訳の分野においては非常に便利かつ効率的だと感じているし、コーディングや文の校閲、アイデア出し等についても、しっかり中身を把握・管理している限りにおいては2有用だとも感じる。
LLM自体はただのツールだ。乱暴に言えば、学習データのパターンを非可逆圧縮した「モデル」にプロンプトを与え、統計的に尤もらしい回答を算出する仕組みにすぎない。LLMを「電力の無駄遣い」だと嘲る人間もいるが、それを言うならあらゆる娯楽がそもそも無駄遣いである。過剰なデータセンターの建設はLLMを取り巻く「バブル」の問題であるし、LLMの悪用やらひどい使われ方も、ほとんどは黎明期ゆえに生じている混乱であると思っている。バブルの盛り上がり的には山の頂点……から、ようやく若干下がってきたところだろうか3。
電話ですら黎明期は罵詈雑言や無礼な使われ方が著しかったというし、LLMについても、数年もすれば必要な整理や規制は大方揃うことになるだろう。その上で、最終的にもたらされるのが禁止ではなく秩序であることは、もはや疑いようがない。
逆に言えば、今ほどLLMの能力ばかりが称揚され、その使われ方・コストを問われない時代というのは今後存在し得ないとも言える。LLMに頼り切ってビジネスやコミュニケーションを乗り切ろうとする人間は、電話黎明期に迷惑電話を連発していた層と大差あるまい。そして、LLMが最も苦手とする分野がビジネス及びコミュニケーションである。
ゆえに、碌にレビューもせず(当然だが、事実誤認・誤字脱字・冗長表現を放置しているのは「レビューした」とは呼べない)、LLMが作った冗長な文章を公開・提出・送信するのが野放しになっている現状は、どう考えてもおかしい。
プログラムのソースコードは(無数に論点や言いたいことはあるにせよ)100歩譲っていいとしよう。これは記法が厳密に決まっているものだし、プログラムの動作には正解か不正解かの二つしかない。極端な話、どれだけ冗長・雑なコードであっても正しく動作するのであれば、それは正解である。
しかし、文章はそうではない。純粋なコミュニケーション手段である。小説、評論、チャット、条文、日記、あるいは罵詈雑言や猥談であっても、最終的には自他に対してのコミュニケーションに帰結する。ソースコードと違い、明確な正しさが存在しない。相手・文脈によって変わりうるし、法であっても「条文にこう書いてあるから絶対にセーフ・アウト」とならないのは、自衛隊の存在が証明している通りだ(批判の意図はない)。
したがって、LLM生成文をそのまま——あるいは、そのほとんどを——使った記事・文章を公開するような行為は、根本的に矛盾していると言わざるを得ない。のだが、世界は未だそういう感じなので、当然、インターネットも影響をもろに受けている。
かつて蔓延っていたSEO目的のスパムサイトも今や昔。現在は、意味のない絵文字とダラダラ長いだけで中身のない文章——通称AI Slopの提供サイトに様変わりしている有様だ。
また、Googleで検索すると co.jp のドメインを引っさげながらもダラダラと露骨なLLM生成文を垂れ流しているサイトも数多く見かけるようになってきた。ゆえに、ChatGPTやClaude、GeminiといったAIに文章を投げて「調べて・サマリを教えて」と尋ねて自己防衛する人間が増えるのも、当然の帰結であろう。これによって被害を受けているのは、真面目にコミュニケーションを取ろうとしている人間である。例えば……私、とか4。
見分け方を考える
かくも悲しい状況に身を置く「真面目」側の視点から考えて、ゴールを「まだコミュニケーションが取れそうな人類を、優れたS/N比で効率的に発見する」と置くことにしよう。
邪悪なco.jpをGoogleへ「スパム」としてフィードバックする以外にできることといえば、ドメインやアカウントをブロック・非表示の刑に処することくらいだろう。しかし、これを行うためには内容をよく読み「コミュニケーション不能(すなわち、スロップが大多数であり自己矛盾に陥っている)」という判断を正確に行う必要がある。だが、LLMの能力が向上するに伴い、パッと読んで明らかにLLMと判別できるケースは徐々に減ってきているのが現状だ。
そこで昨今世間を賑わせているのが、いわゆる「AIチェッカー」と呼ばれるもので、端的に言えば「LLM(AI)生成文を検知するAI」の提供サービスを指す。『バケモンにはバケモンをぶつけんだよ!』理論そのものだ。
人類の虚無さをなんとも見事に表現した夢のシステムではあるが、しかし弱点もある。検知のために学習データを用意する必要がある都合上、対応言語にバラツキがあるのだ。そして対応というものは需要と供給で決まるため、極東の島国でしか使われない日本語なる言語に対応した検知サービスはなかなか登場してこないか、精度に難があったわけである。
が、そんな中でも Pangram という検知サービスがどうやら日本語をサポートしているらしい。しかもどうやら、精度もそこそこいいようだ5。が、調べてみても散発的な利用報告(しかもほとんどが無償枠によるごくわずかな検証しかしていない)しか出てこない。うーむ、ならば検証してみる価値はあるか……?
そういうわけで、相手がコミュニケーション可能かどうかを見分けるべく、Pangramを試してみることにした。
Pangramの検証
プランとコスト
検証にあたり、まずは Pangram の価格を調べてみた。 Pricing ページは以下の通り(なお、以下の画像はCC0でライセンスされない)。
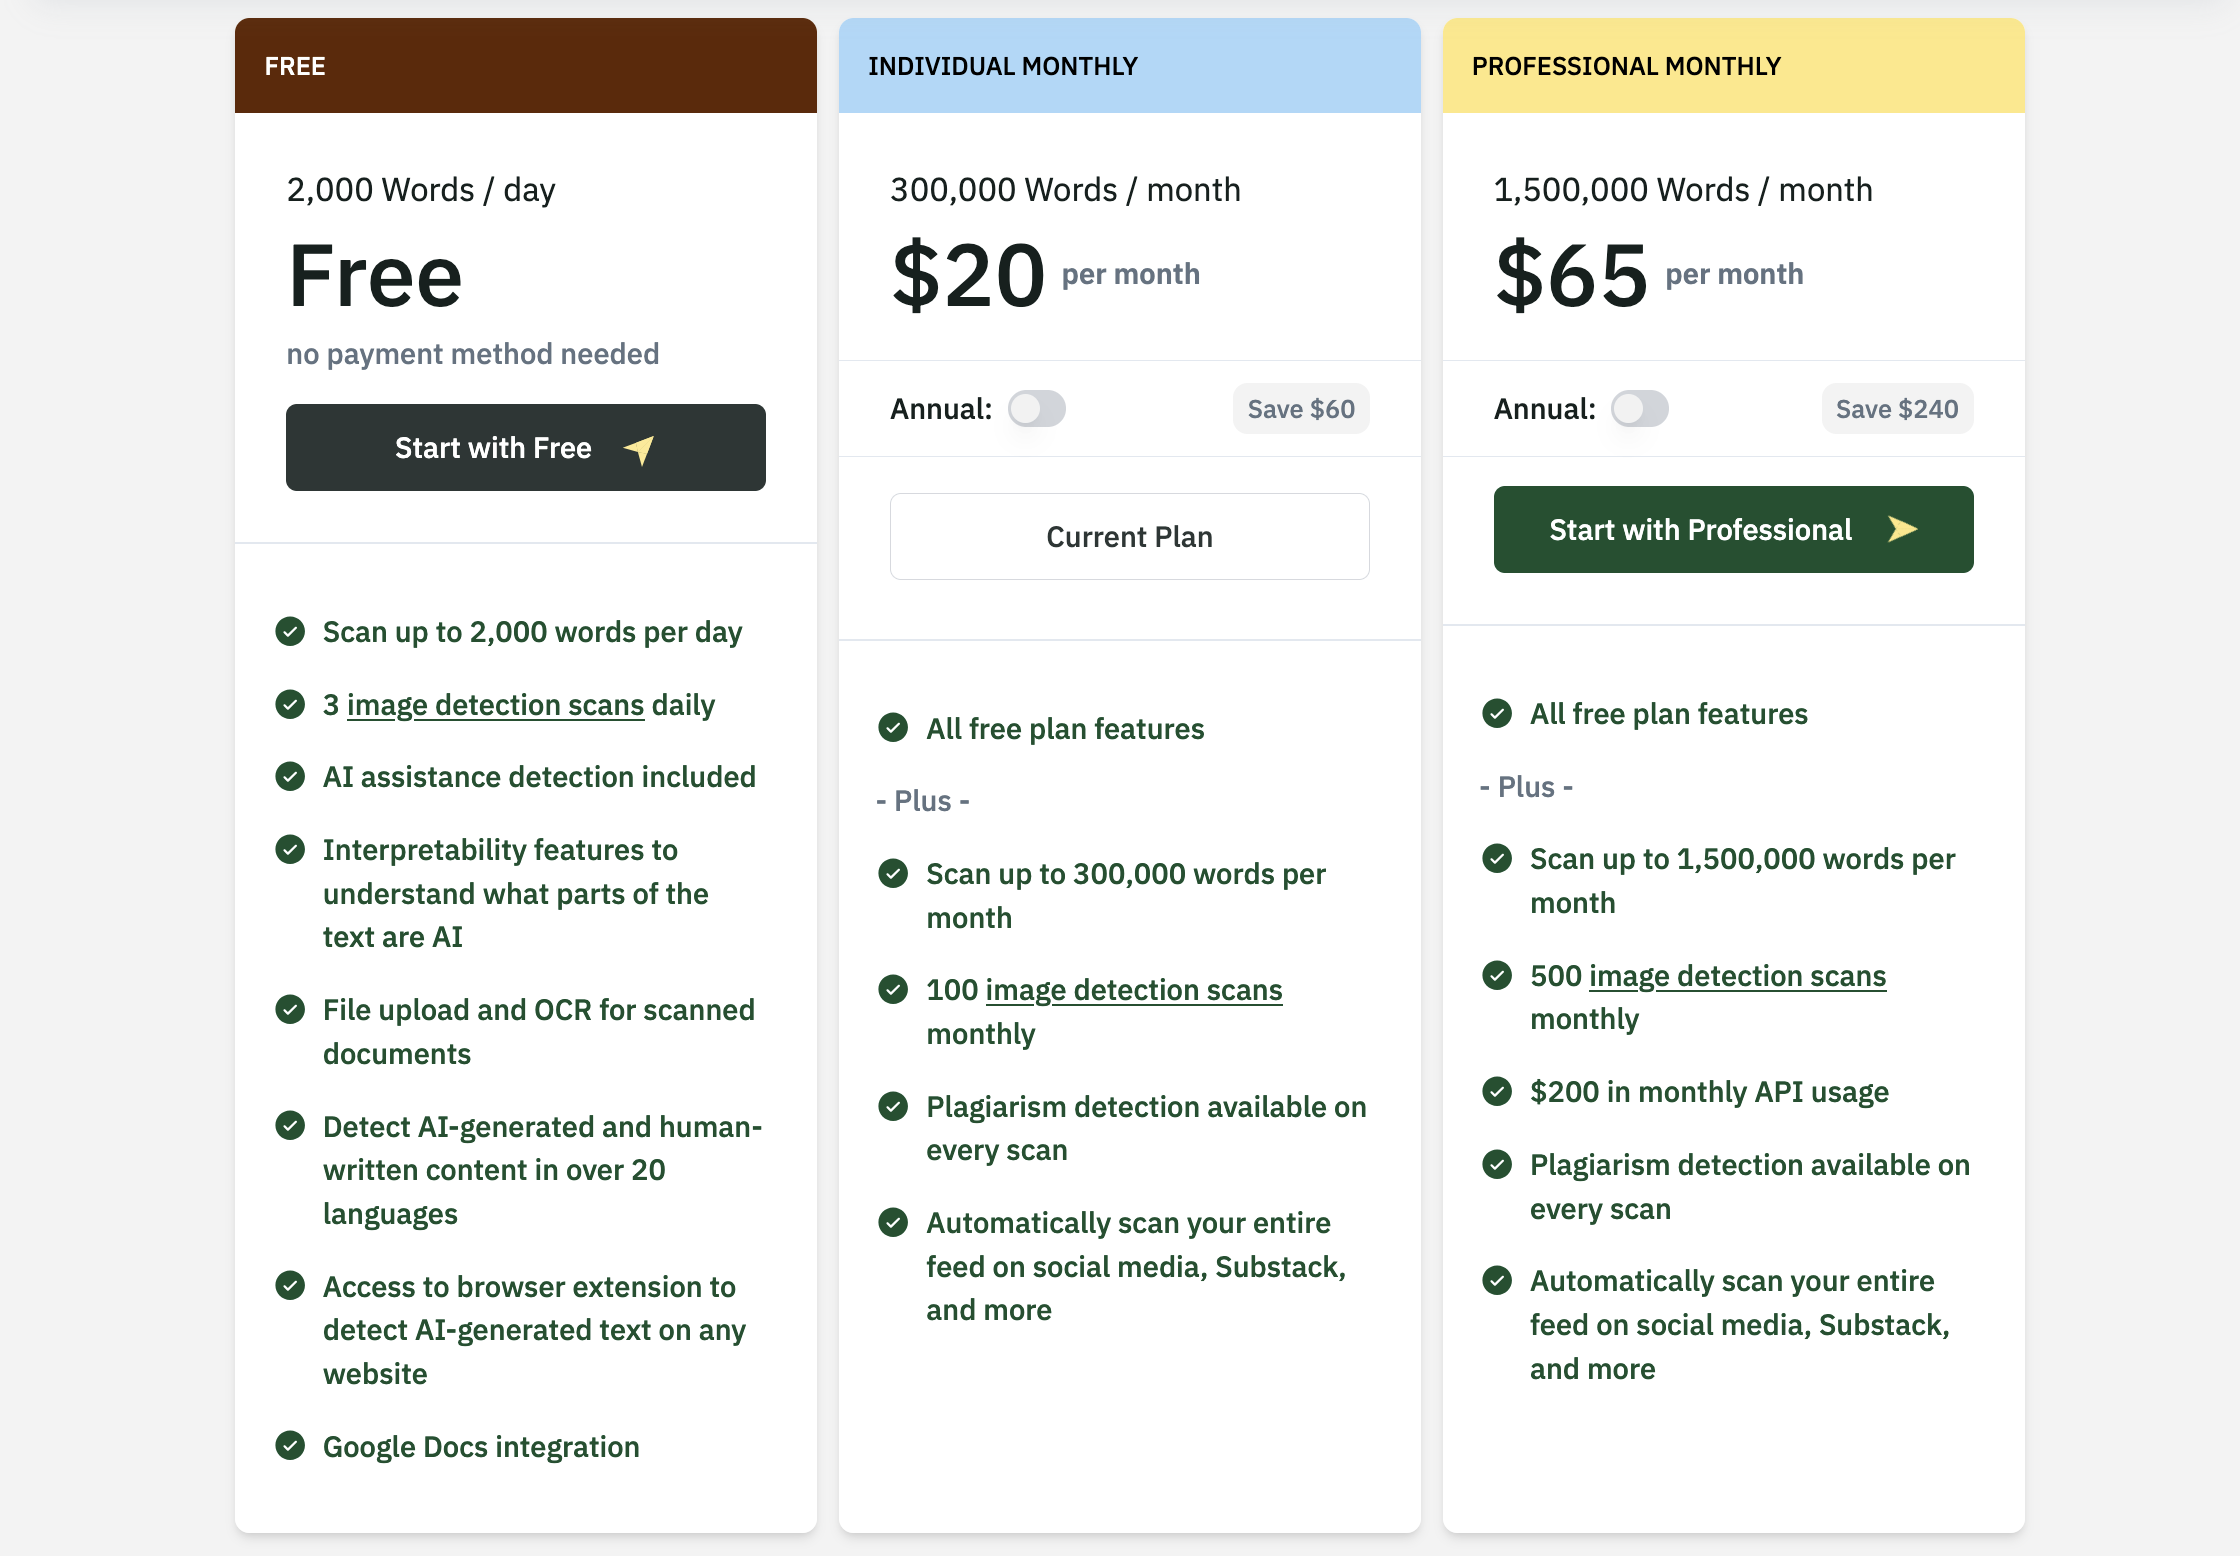
これによると、無償版は一日2000 wordsまで(お試し程度にしか使えない)。個人向けで使うには 300,000 words / 月 まで使える $20 / 月 の INDIVIDUAL monthly が良さそうだ。というわけで、このプランに加入してみることにした。なお、画像も月100枚まではスキャンし放題らしい。
ということで、加入して7日間は無料(加入プラン相当の割当が7日間だけ先にもらえる)ということだったのでしばらく遊んでみた結果、プラン周りで分かったことは以下の通りである:
- 300,000 words / 月と聞くとかなりの量に思えるが、いろいろ試すと余裕がない。
- 実際に配られるのは 3,000 creditsで、 1 credit = 100 words。つまり 100 words 未満であっても 1 credit 消費する。
- 画像スキャンとは完全に別枠。
- 例えば 私が年始に書いた記事 も、タイトルから脚注までをそのままコピペすると5831 wordsとカウントされる。つまり、同じ長さの記事を50件程度しかチェックできない。
- そのため、いろいろサイトの記事を気軽にコピペしてチェックする用途だと、すぐにリミットへ到達してしまう。
- 一定文量があるサイト、例えばzennやnote、ニュース記事などをチェックしようとすると、みるみる残量が減っていく。
- が、LLMが書いたと思われる記事のうち8割以上は特徴的6なので、時折気になった記事のみをチェックする用途であれば十分かもしれない。
- 実際に配られるのは 3,000 creditsで、 1 credit = 100 words。つまり 100 words 未満であっても 1 credit 消費する。
- リミットに到達した場合、即日にプランの金額と同じ額を払うことで、その日を起算日として制限をリセットすることができる。
- 例えば 8/1 に $20 プランに加入し 8/15 に使いきった場合、 8/16 に $20 を払えば 8/16 から加入した扱いになって、制限が解放される。
- 年払いだとどうなるかは不明。
- 例えば 8/1 に $20 プランに加入し 8/15 に使いきった場合、 8/16 に $20 を払えば 8/16 から加入した扱いになって、制限が解放される。
- Plagiarism(盗作)チェックもあるが、使う場合は通常のLLMチェックと同額の credits が別で消費される。つまり、コストが2倍になる。
したがって、いろいろな記事・文章をとにかくLLM文判定にかけまくりたい場合、金額には目を瞑って PROFESSIONAL プランを選択すると良いかもしれない。
なお、API経由でチェックする機能もあるがこれは別料金。価格はなんと 100 words あたり $0.05 というバカ高い金額なので、全くオススメしない。INDIVIDUAL と同じ 300,000 words をスキャンした場合、単純計算だとAPI経由というだけで $150 になる計算だ。一般人はお断りということなのだろう。
同額 $20 を出せばChatGPT Plusが使える2026年現在としては、これらを踏まえると、投資対効果は人を選ぶと言えそうだ。AIの補助を利用して文章を書くライターや、ヘビーなインターネットユーザーであれば、1ライセンス持っていても損はないだろう。
まずは自分のブログの記事から試す
さて、プランについても分かったことだし、LLM文でさっそく検証を……と言いたいところだが、灯台下暗し、あるいは言い出しっぺの法則という言葉もある通り、まずは自分が過去に書いた文章がLLM文判定されないことを確認することにしよう。
とはいえ、だ。前述したとおり $20 プランではブログの全記事をチェックできるほどの枠はない。そのため、このサイトが公開している2025〜2026年までの計6つの記事のタイトル〜脚注までをそのまま放り込んでチェックすることにした。
結果のリンクは以下の通り。結果として、全てが人間判定となった。
- 2025年の記事(全て Human: 100%)
- 2026年の記事(全て Human: 100%)
確かに、いずれもLLMに直接書かせていない7ので、この結果は正しい。N=6かつ同一筆者なのでこれだけで信用できるとは言えないが、簡単に偽陽性が出るというわけではなさそうだ。
こうなると、逆にLLMに書かせた文を投入したらどうなるのかという興味が湧いてくる。ということで、例によって 年始に書いた記事 をいくつかのモデルに読み込ませて、プロンプトを与えてリファインさせた上で、Pangramでチェックをかけることにした。なお、モデルは OpenRouter 経由で利用し、Thinkingはいずれも有効としている。
与えたプロンプトは以下だ。
これは私が年始に書いた、2025年の振り返り記事です。これが仮に2037年の振り返り記事だったらどうなるか、を推測し、同じくらいの長さで執筆してみてください。
結果は以下の通りで、全てが「LLM文判定 = AI Generated 100%」として判定された。完全なサンプルまで渡したのにもかかわらず、簡潔に指示をして書かせると引っかかるようだ。
- (GPT-6 Astra) https://www.pangram.com/history/d9d3d63b-fd4e-482d-b140-a2070eb28ed0
- (GPT-5.6 Luna) https://www.pangram.com/history/7b33a0fa-506c-4426-8cb6-20a5bae4ce1a
- (Claude Sonnet 5) https://www.pangram.com/history/251f68c7-40dc-45f5-bb37-41631d2f3433
- (DeepSeek V4.1 Flash) https://www.pangram.com/history/66f73ff9-b147-4f13-8d0e-b5ca7ee22e0f
- (Gemini 3.8 Flash) https://www.pangram.com/history/9c8a126e-2f0e-4a37-ab07-fa7a19054f6e
少なくとも私の記事の例においては、偽陽性・偽陰性が強すぎるというわけではないことが分かった。LLM判定機としてスタートラインには立っていそうではある。
ならば、次は私の記事以外の様々なジャンル・パターンで試してみることにする。
小説・評論
日記調のものについては前述した通りなので、今度はより創作寄りな小説・評論を扱わせてみる。
なお、先の結果から GPT-6 Astra でやったところでそんな変わらなそうなのと、コスト・待ち時間の理由から、GPTはLunaのみに限定することにした。私が富豪であったら良かったのだが。
題材としてはまあ何でも良かったのだが、権利の諸問題が発生しにくい題材としたい。そう考えると公益性の高い公文書がよさそうだ。その上で、ちょうど脳内に「森羅万象」という言葉が残っていたので、かの有名な国会の答弁に端を発した質疑応答8を題材にすることにする。
小説の生成を行うためのプロンプトは以下とした。
平成三十一年二月に行われた以下の国会質問と答弁に対して、純文学のテイストで、情景描写豊かな短編小説を執筆して。

https://www.shugiin.go.jp/internet/itdb_shitsumon.nsf/html/shitsumon/a198040.htm
https://www.shugiin.go.jp/internet/itdb_shitsumon.nsf/html/shitsumon/b198040.htm
これによって生成させた小説の判定結果は、それぞれ以下の通り。 こちらも全てが「AI Generated 100%」として判定された。
- (GPT-5.6 Luna) https://www.pangram.com/history/e929360a-0ff5-41c2-9841-70d8a41e967b
- (Claude Sonnet 5) https://www.pangram.com/history/7c5d440b-6d25-498a-9531-927da3f9b047
- (DeepSeek V4.1 Flash) https://www.pangram.com/history/1b826b7c-e827-452d-a4ca-2e84f92da1fa
- (Gemini 3.8 Flash) https://www.pangram.com/history/72789e2f-ede5-4677-8fa9-3761e4672206
とはいえ中身を見ていただければ分かるように、この時点ではかなりLLM味の強い文体となっていることが分かる。指示も題材を与えただけなので、それも当然だろう。
なので次に、人間が書いた文を手本とし、それになるべく近づける方向だとどうなるかを探ってみることにした。手本とする文は悩んだが、私が書いてしまうと誘導も可能そうだったので、既にある既存のものをなぞらせたい。かつ、権利的に問題になりにくいもの……と思案した結果、青空文庫9にて公開されている(うち、著作権が消滅している)宮本百合子氏の「待呆け議会風景」を手本とすることにした。内容的に小説よりも評論に近い文体だが、選んでいる題材が近い方が精度も上がると考えたためだ。
なお、手本にするにあたり、念のため「待呆け議会風景」の原文も以下の通りPangramにチェックさせた。が、当然ながら「Human 100%」となり、人間が書いた文章であると判定されている。
https://www.pangram.com/history/18ba3728-b452-4385-bc01-3e69d4952e9c
原文の判定が問題ないことを確認したので、それぞれのモデルに対し、先ほどの小説を出力したのと同じ会話に続けて以下のプロンプトを与えてみた。理屈上は、これで人間らしい出力が得られるはずだ。
以下の青空文庫の文を手本とし、大きく改稿せよ。

https://www.aozora.gr.jp/cards/000311/files/3969_12829.html
それぞれ待つこと数十秒後、出てきた結果は以下の通り。残念(?)ながら、 手本を与えて真似させたにも関わらず「AI Generated 100%」という結果が得られた。
- (GPT-5.6 Luna) https://www.pangram.com/history/3aca238a-c0b6-45f7-8234-3bc92922bc99
- (Claude Sonnet 5) https://www.pangram.com/history/e4b7ce58-99ed-4966-ab73-4a288af9060c
- (DeepSeek V4.1 Flash) https://www.pangram.com/history/9cc58f80-450f-4c97-a8c7-0b68bcf2447e
- (Gemini 3.8 Flash) https://www.pangram.com/history/d7929ce8-09c3-4338-a1be-90dee2b242fb
したがって、明示的に手本をベースにさせたとしてもLLMチックな文の要素は現れてしまうようだ。
ちなみに、これらについては「手本」を用いているため、Pangramの盗作確認機能も有効にしてチェックを行った。が、いずれも検査結果は「問題なし」であった。
DeepSeekの例ではあからさまに手本を再現しようとしている傾向が強い気がするのだが、あくまで大きく変更が加えられていると盗作判定とはならないようだ。とはいえ、これで下手に誤検知をされたとしたらたまったものではない部分と思うので、疑わしきは罰せず式が最良なのかもしれない。
さて、これらを踏まえると、「事細かく指示」や「大きく人間が改稿」を行わない創作作品については、かなり良く検知できるらしいということが分かった。
つまり創作作品というのは自由度が高いために、LLMチック・機械的な表現が連鎖するようなものだと、かえって目立ちやすい(検知しやすい)のではないか、という仮説が成り立つ。
なら、逆に自由度の低い文章——すなわち「テンプレートがはっきりしており、そこから外れることが極めて嫌われるもの」であればどうだろうか。
具体的にどういうものかというと、例えば、公文書である。
公文書風
あくまでホンモノではないので「風」と付けているが、では、LLMが作成した公文書(風)の文章については検知ができるのだろうか。
今回は折角なので「LLMで適当に作られた業務の成果物(ワークスロップ)について、注意喚起を通達する文書」を作らせることにした。LLM自身にLLMを批判させるわけである。
プロンプトは以下の通りだ。
https://www.bunka.go.jp/seisaku/bunkashingikai/kokugo/hokoku/pdf/93651301_01.pdf
この文書を読み込んだ上で、「業務においてAIを濫用した『ワークスロップ』なるものが問題となっている」「これらについて、あくまでAIではなく提出者に責任がある」という旨を周知する公用文を作成してください。
新規チャットを開始し、これを与えて生成させたところ、結果は……なんと、4モデルのうち2モデルの出力が「人間」として判定された!
- LLM判定
- (GPT-5.6 Luna) https://www.pangram.com/history/f1e3a26a-3239-4b06-b8e8-dca77a411685
- (Gemini 3.8 Flash) https://www.pangram.com/history/85418c59-fa9e-4015-aa6a-848efd931016
- 人間判定
- (Claude Sonnet 5) https://www.pangram.com/history/8f2ec262-dca9-48d0-8d78-8f6c31d1bd46
- (DeepSeek V4.1 Flash) https://www.pangram.com/history/b785da3f-22d5-4831-b03c-27e0b7d1570d
これは重要な発見である。と同時に、先ほど述べた仮説
つまり創作作品というのは自由度が高いために、LLMチック・機械的な表現が連鎖するようなものだと、かえって目立ちやすい(検知しやすい)のではないか、という仮説が成り立つ。
が、かなり現実味を帯びてきた。
LLM文判定の仕組みを推測する
ここまでで、日記、創作、公文書と一通りの文章の検証を終えた。結果、やはり公文書のように「誰が書いても同じような文体になる」ものであれば、検出を掻い潜ることができる可能性が示唆されたのではないか。
これを裏付ける資料がないかを探してみたところ、まさにPangramの公式ブログにある「No, LLMs don’t just mimic human text」という記事で仕組みが解説されているようだ10。
記事の主張をざっくりまとめると、主に以下となる:
- LLMについてよくある誤解は「LLMは学習データを単に真似ているだけなのだから、人間が書いた大量の文章を学習したLLMの文は、じきに人間と区別がつかなくなる」というものだ
- 実際は異なり、LLMは「プロンプトに対し適切な反応をする」ために事後学習というものをしており、これによって「回答はどういう形式・内容であるべきか」というものが大なり小なり定まってしまう
- これをしないとうまく会話にならない上に、爆弾の製造方法など、非倫理的な内容もペラペラ話すトンデモLLMが完成してしまう
- 副作用として、特定の傾向・言葉選びが強くなってしまう
- これは「事後学習」を行う限り避けられないので、こうした特徴を検出することで、LLMかどうかは見分けることが(今後も)可能なはずだ
この主張を踏まえると、公文書のようなものを生成させた際に検出が漏れてしまった理由も推察できる。「公文書(公用文)」というのはそれ自体が強力な傾向・言葉選びを持つため、LLMの上記特徴が目立たないということなのだろう。
一方で、そういった制限がない通常の創作や日記といった文章にした瞬間、特徴が表に出てきてしまうのではないだろうか。
そして記事が主張する通り、今後もこの傾向はなくなるどころか強くなる可能性すらある。
コーディングエージェントなど、圧倒的に制約の多い文章(ソースコード)を書かせる需要は増えているし、LLMを明示・規制しようとする動きも各国で活発になり始めているからだ11。
こうした流れによって、分かりやすい特徴というのは現れ方を変えつつも、目に見える形で残り続けるものと考えられる。
まとめ
LLM文への不満というひょんなことから始めた検証だったが、やってみると最後の最後で興味深い結果と洞察を得ることができて、何か得した気分である。
少なくとも、きちんと手を入れて改稿したり、こと細かく指示を出して生成したような文章以外のLLM文については、Pangramは割と検出してくれるらしいということが分かっただけでも収穫だ。公文書例で示したように偽陰性もありうるし、当然偽陽性もありうることから誤検出リスクは残るものの、怪しげな記事をスキャンした上で「この筆者とコミュニケーションが可能そうかどうか」を考える分には、まあ使えるのかもしれない。
ちなみに、この検証のためだけにPangramは二ヶ月分の料金(7000円くらい)を支払った。が、特にスキルが身についたわけでもないというのが悲しいところだ。面白かったからいいのだけれど。
気になる方は、ぜひPangramを試してみてほしい。
余談
詳細は省く程度の余談だが、8月後半の某日にZennのランキング上位10件の記事をPangramにかけてみたところ、おおよそ半分がLLM文と判定されたこともあった。
賛否はともかく、まあ、現在の技術言論の空間はそういう状況だということだ。今後どうなるか・どうあるべきかは、もはや誰にも分かるまい。
日々何かと移り変わりが激しい割に中身がないので、脳みそを使わず雑談するのにちょうどいいのかもしれない。 ↩︎
これがとにかく難しいわけだが。それなりに経験を積み、かつ専門性を一定程度有していないと、不要なコード・仕様やバグや不自然な造語を量産してしまいがちだ。 ↩︎
『他社に負けないよう、とにかくトークンを気にせずジャカジャカ使い放題!』が持続しない・出費がバカにならないという当たり前の事実を、ようやく世界が受け入れつつある。 ↩︎
本当だよ。 ↩︎
最近では Substack も Pangram と提携し、投稿がAIによるものかどうかを判定できるようになっている(参考)。嫌な世界である。 ↩︎
中でもClaudeが書いた文章は本当に日本語としての質が低いため(造語や単語の癖ですぐに分かる)、あれをそのままzennやらnote、あるいはPR等に貼り付けて公開している人間がいることに驚きを隠せない。自尊心というものがないのだろうか。 ↩︎
誤字脱字や事実確認チェックでは活用していたりしなかったりする。 ↩︎
とはいえ、検知サービス直々のブログ記事であるので、自社に有利な内容を掲載している可能性がある点は割り引いて考える必要があるだろう。 ↩︎
EUのAI Actにおける透明性義務が騒がれた件は記憶に新しい。 ↩︎